02 · 해커톤 · 문제 → 해결
GO.
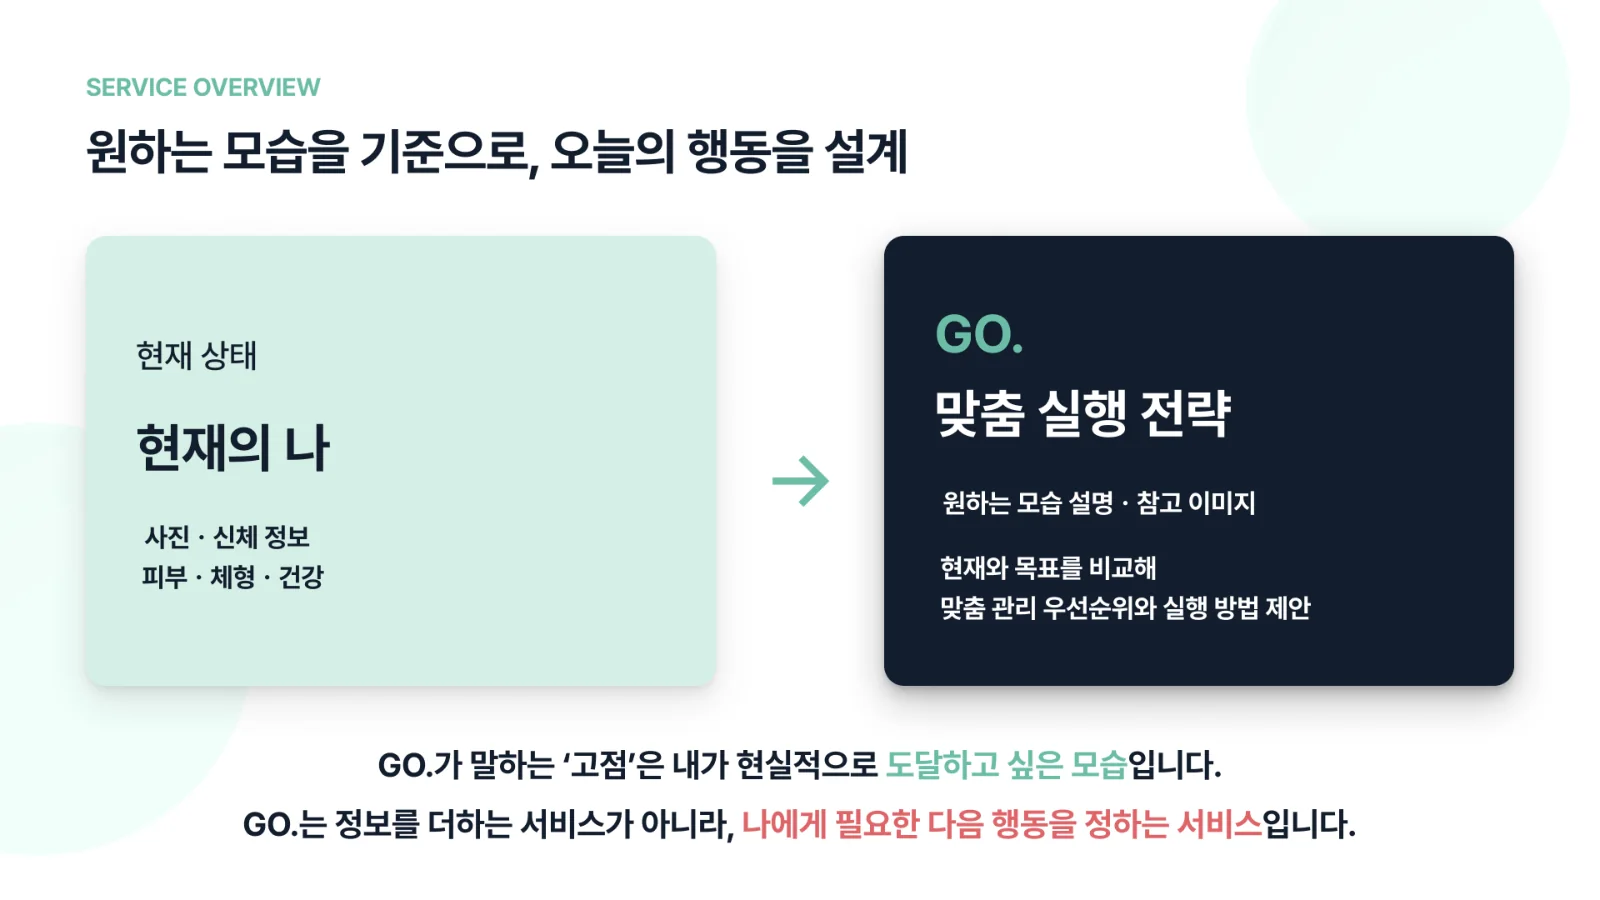
원하는 모습(고점)을 기준으로 오늘의 행동을 설계하는 AI 이미지 전략 서비스
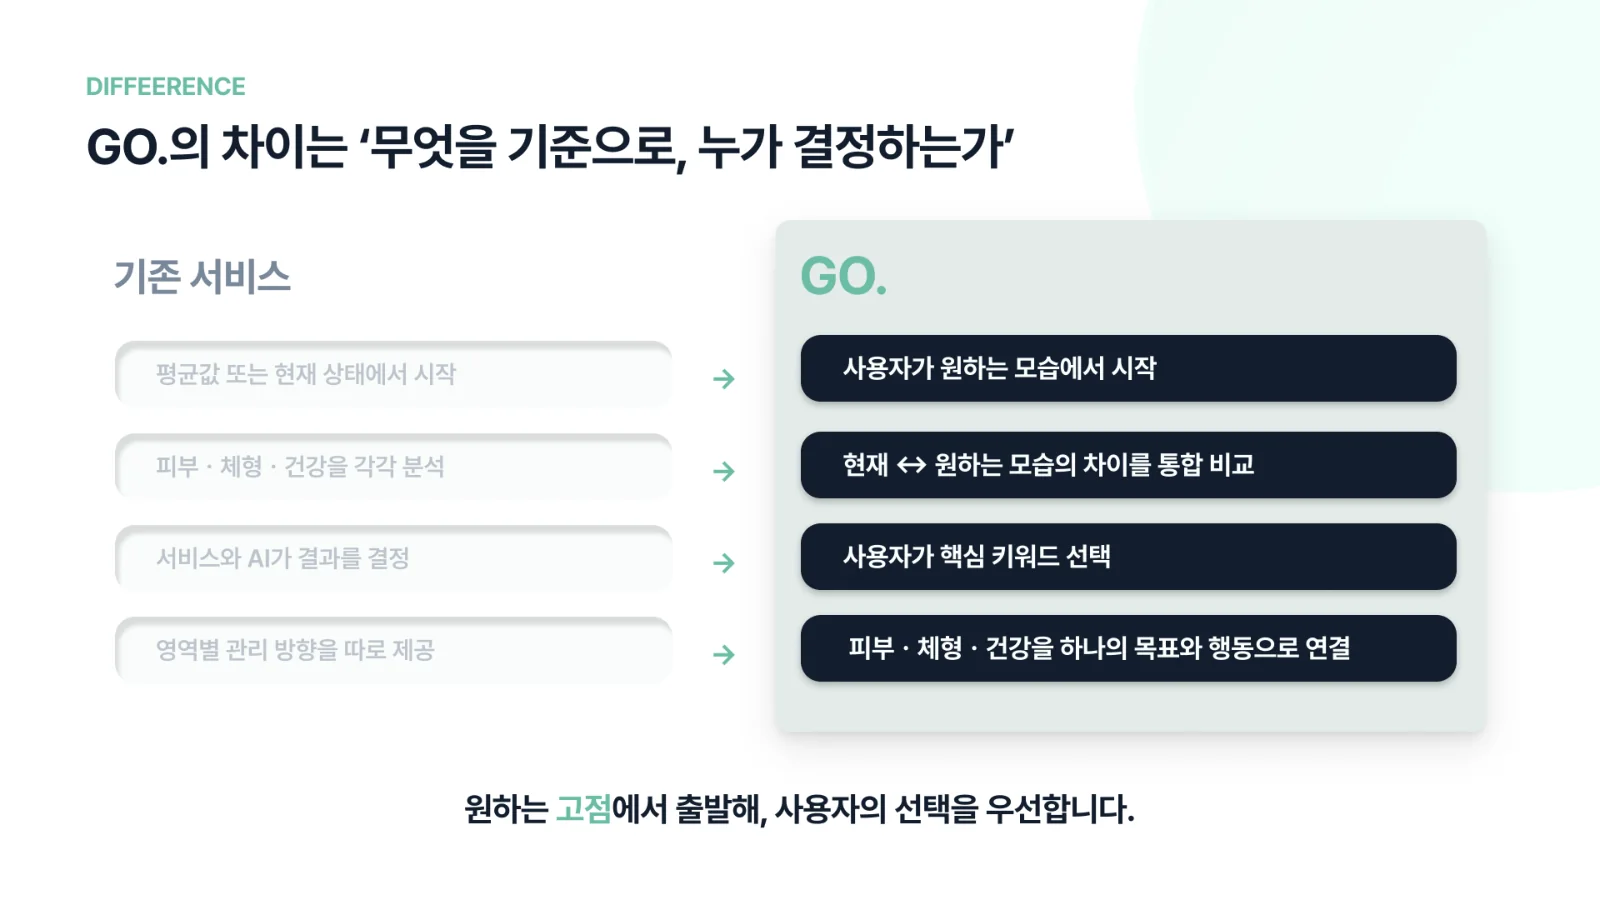
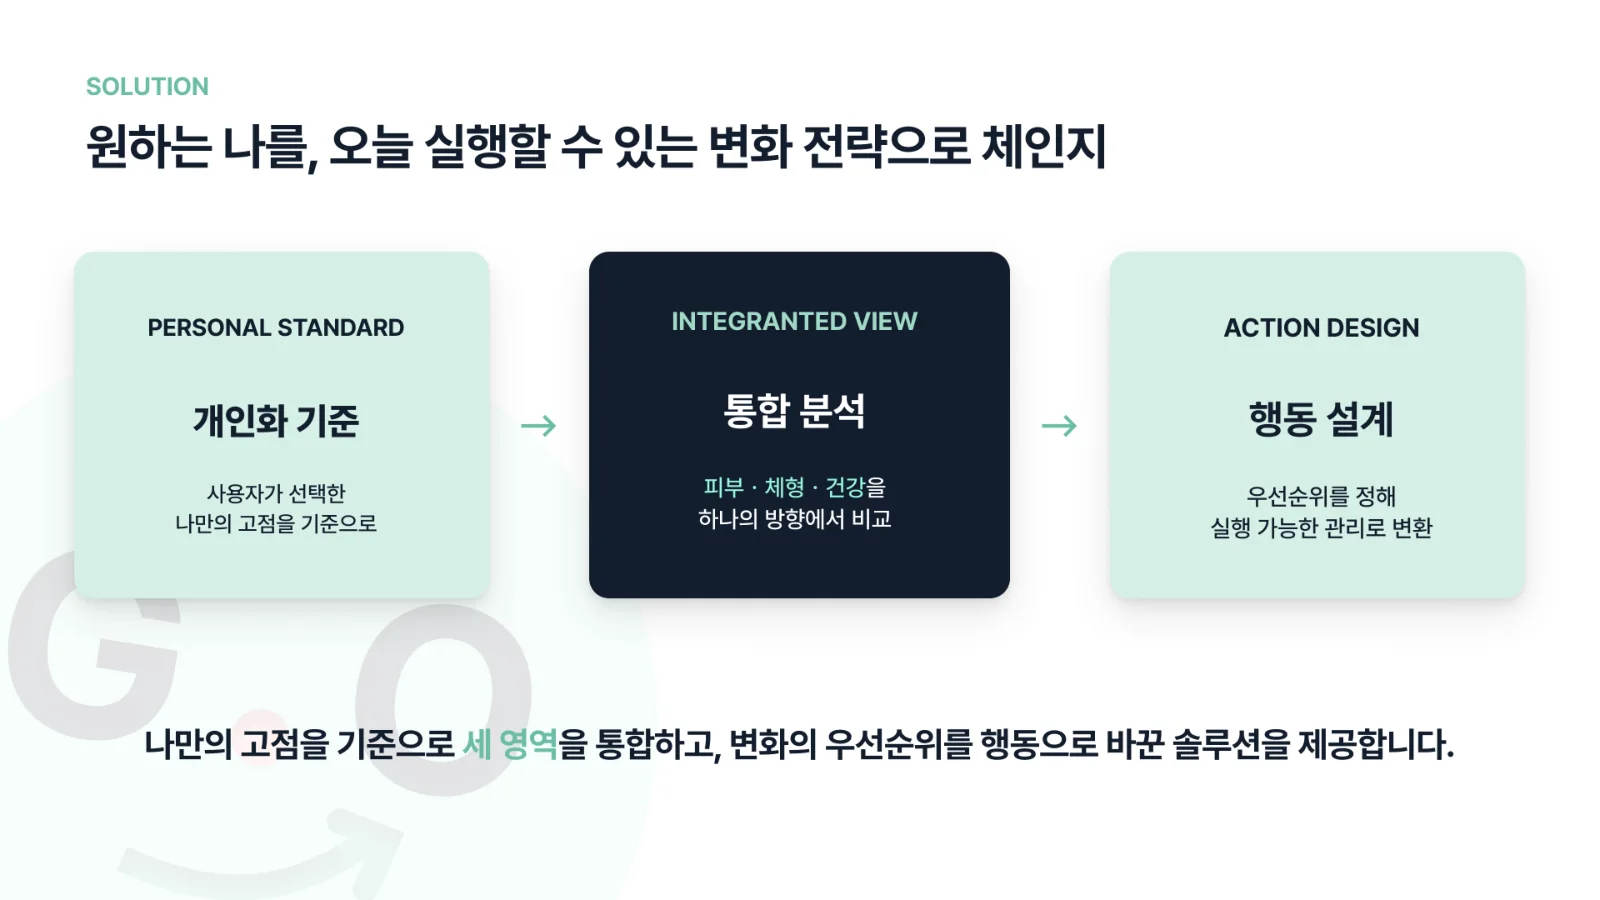
남들의 평균 점수가 아니라, 내가 되고 싶은 모습을 기준으로 오늘 할 일을 정합니다.
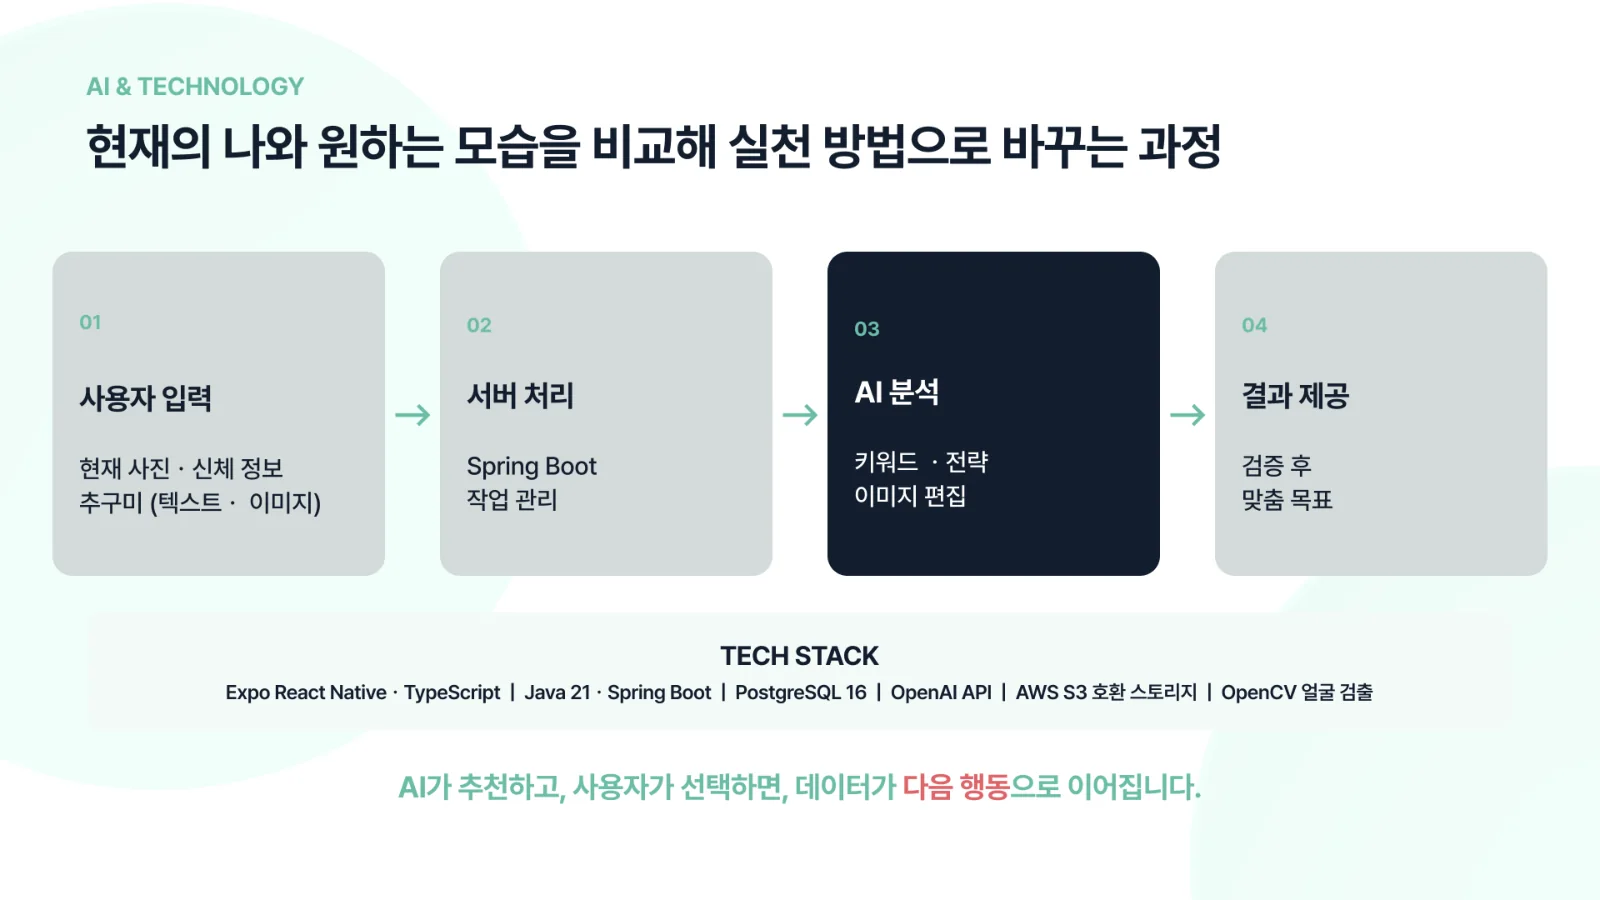
- Spring Boot 3.3
- Java 21
- PostgreSQL 16 · JSONB
- Flyway
- OpenAI API
- S3 presigned URL
- OpenCV
- Expo · React Native
- TypeScript
Project Brief
무엇을, 누구를 위해, 어디까지.
- 타겟
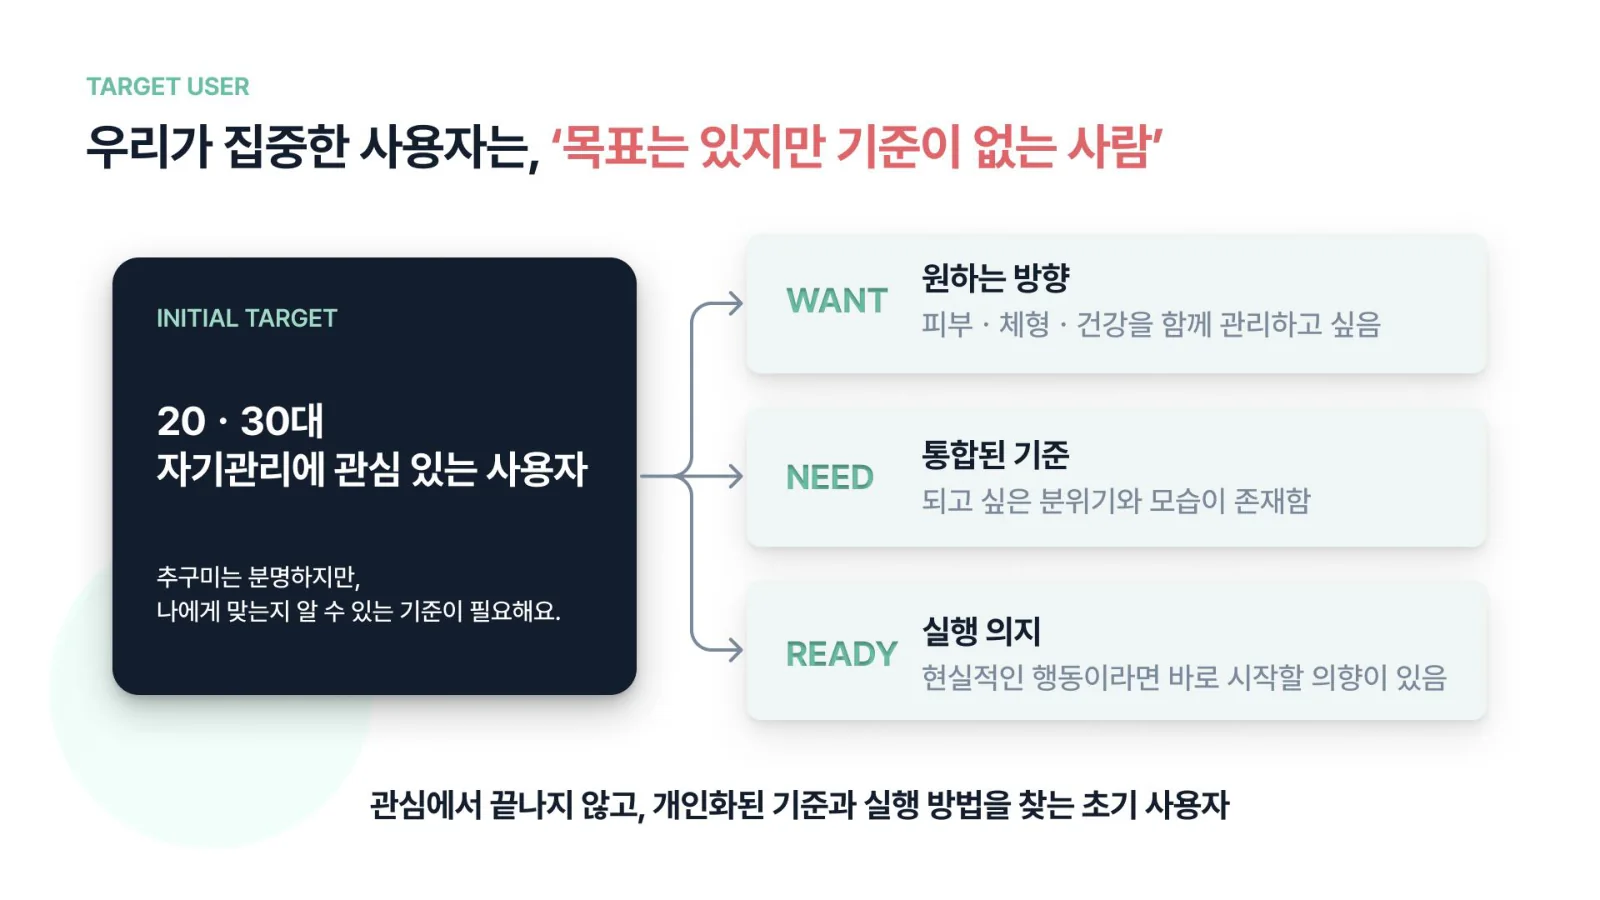
- 레퍼런스는 저장해 두지만 내 얼굴·체형·생활에 무엇부터 적용할지 몰라 탐색을 반복하는 20~30대
- 문제 정의
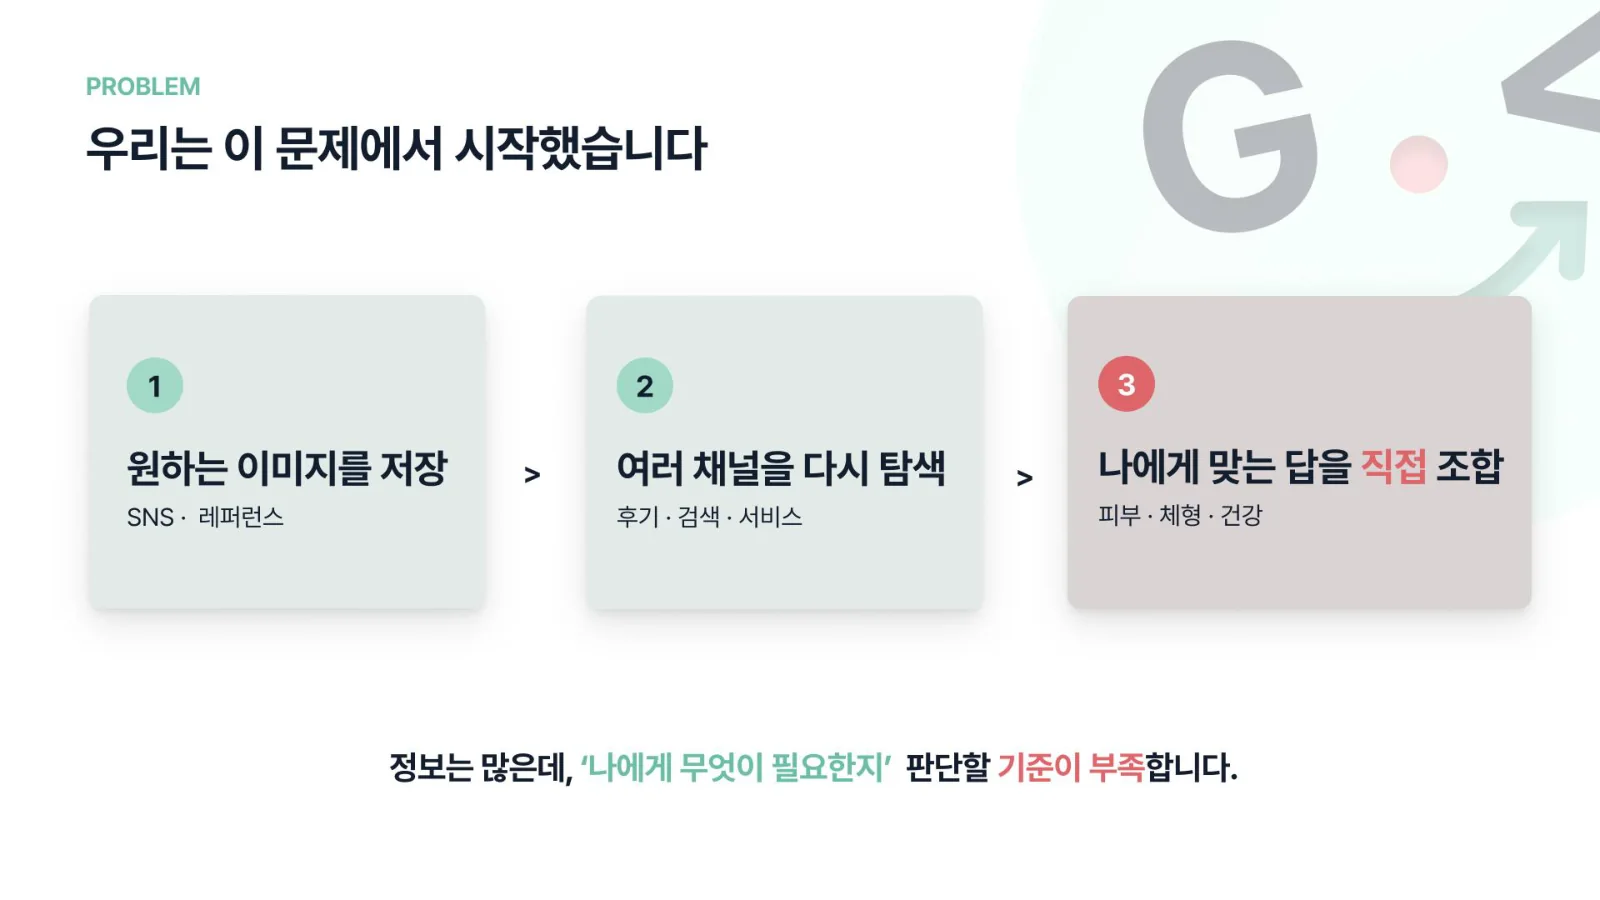
- 정보는 넘치는데 '나에게 무엇이 필요한지' 판단할 기준이 없다. 보편 수치로 관리하는 방식은 피로만 남긴다
- 내 역할
- 백엔드 · AI 파이프라인 · 앱(Expo React Native) 개발 · 배포
- 기간
- 2026.08 · 실개발 8일 (08.13 – 08.20)
- 대회
- 멋쟁이사자처럼 대학 14기 중앙 해커톤 · AAC(Anti-Aging Club) 트랙 · 팀 뚝딱이들
- 팀 구성
- 팀 프로젝트확인 필요
- 현재 상태
- 백엔드는 서버에 배포했고 앱은 EAS 빌드로 실기기에서 전체 플로우가 돕니다. PG 결제 연동과 개인정보 동의 화면은 남아 있습니다
Screens
썸네일을 누르거나 좌우 화살표로 넘기고, 큰 이미지를 누르면 확대됩니다.
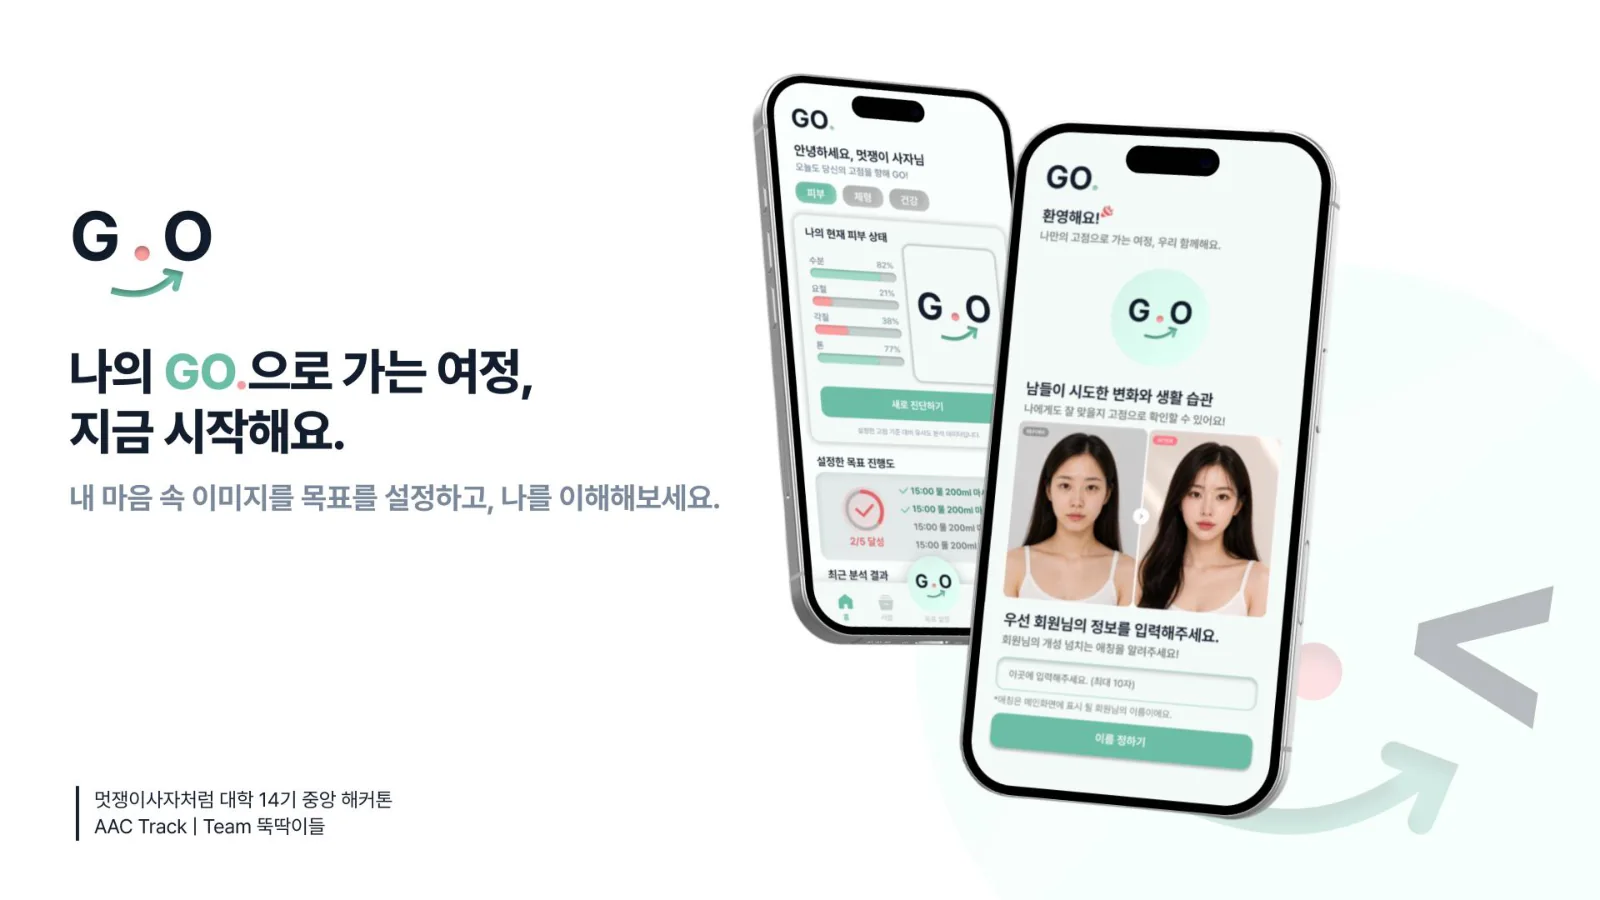
GO. — 내 마음속 이미지를 목표로 설정하고 나를 이해해 가는 서비스
Demo
해커톤에 제출한 시연 영상입니다. iPhone 실기기 녹화, 2분.
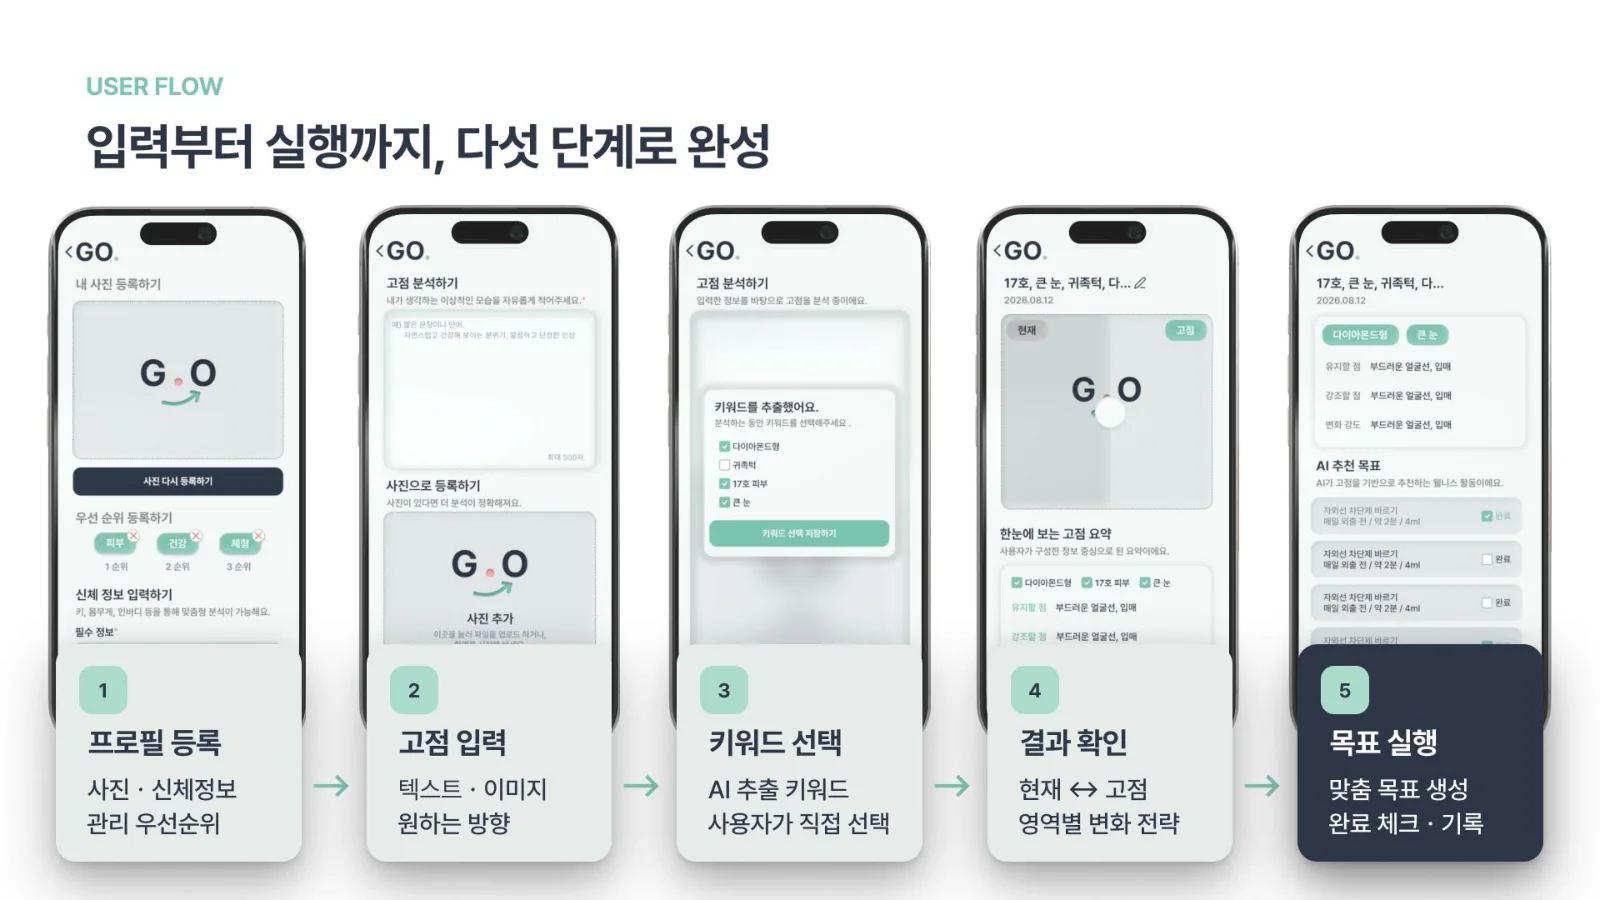
목업이 아니라 배포한 서버에 붙은 앱을 실기기에서 녹화한 화면입니다. 온보딩과 프로필 등록, 목표 만들기, 결과와 오늘의 관리, 캘린더, 홈의 진행률, 고점 분석 입력까지 이어집니다.
Pitch Deck
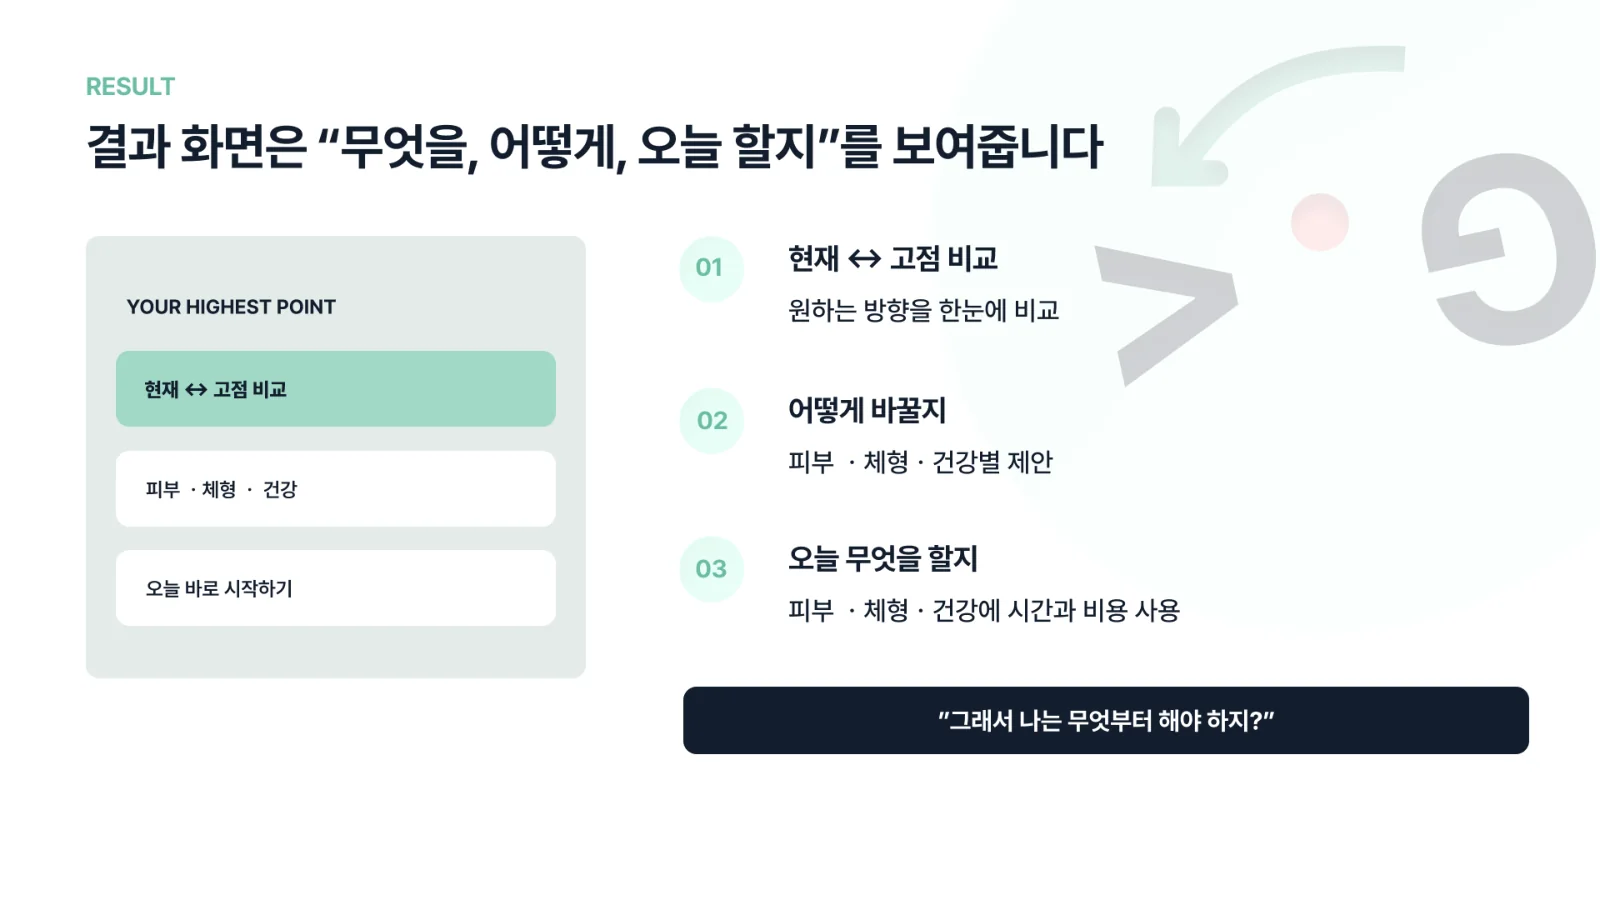
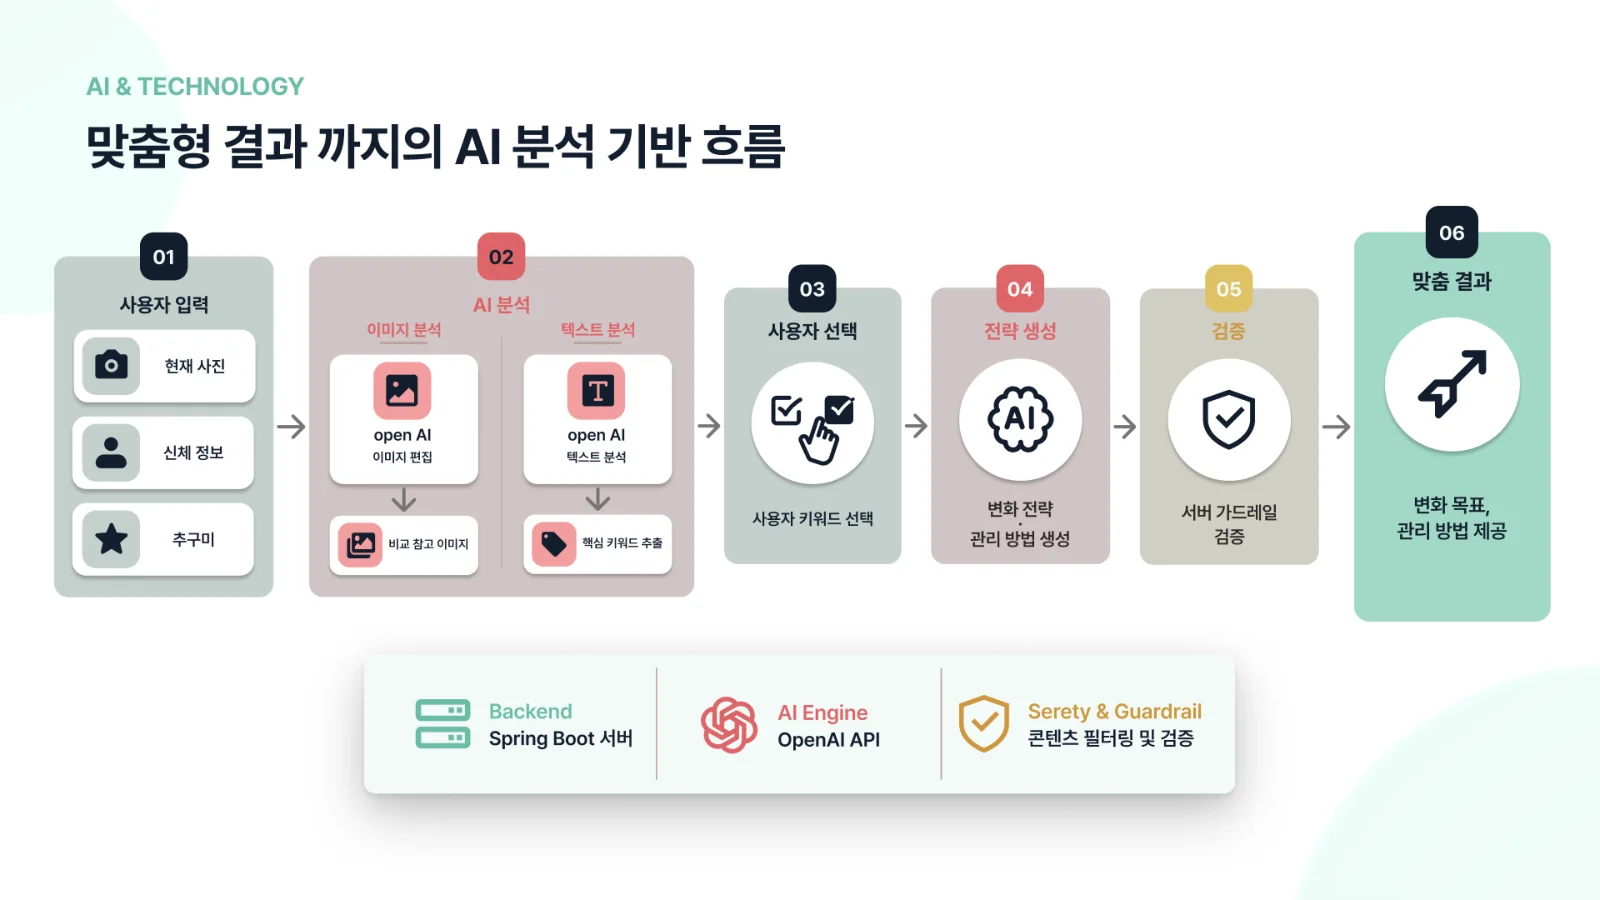
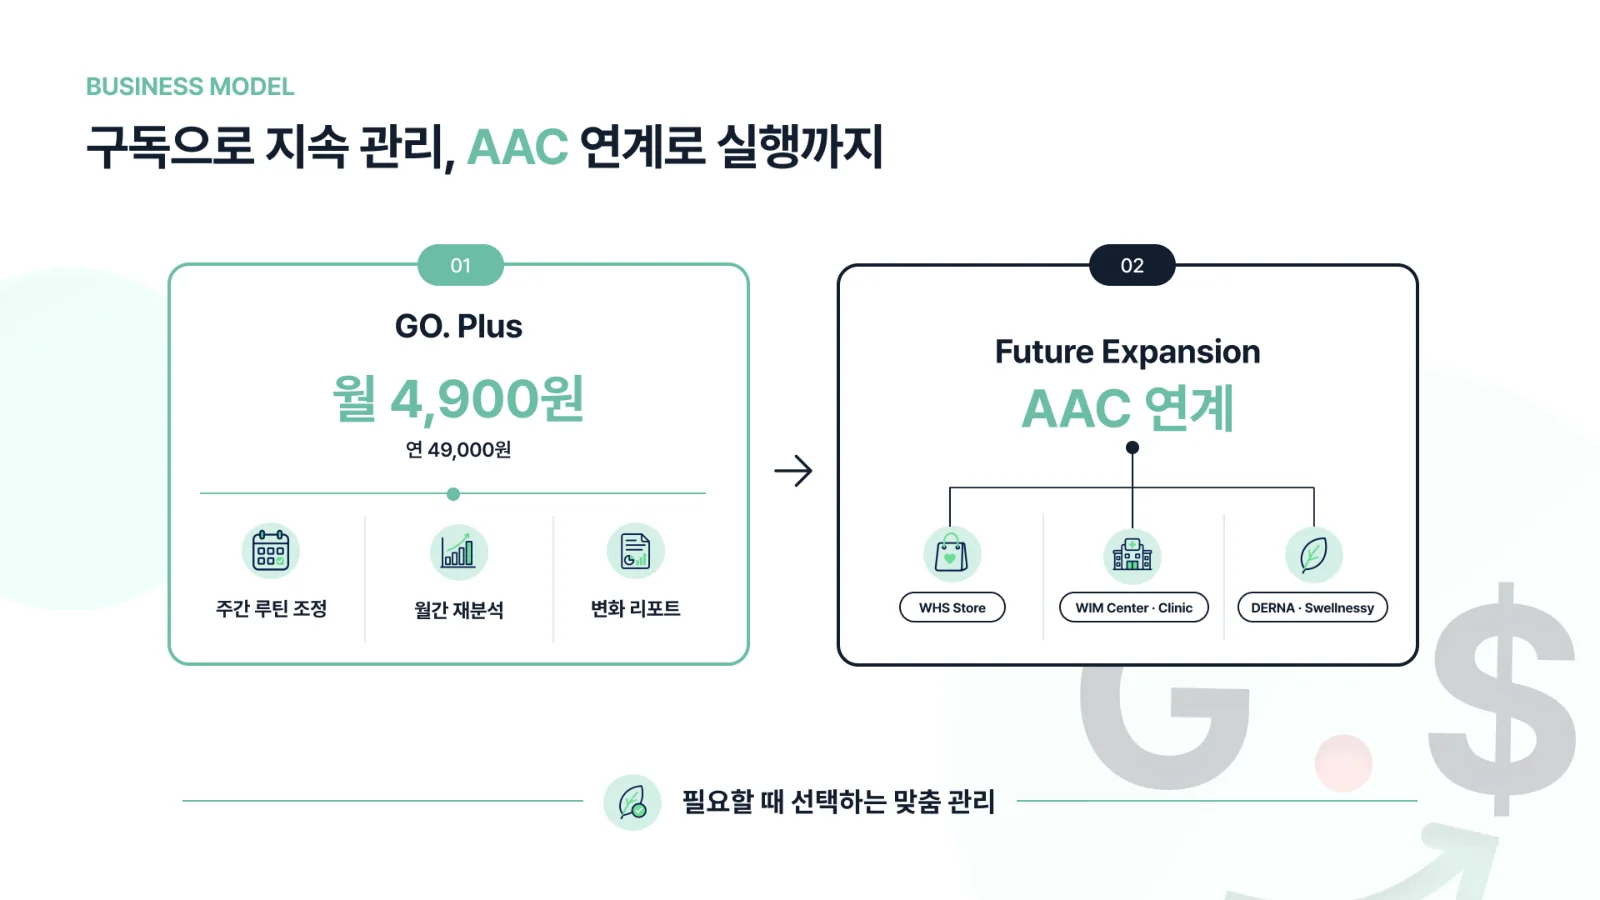
해커톤 본선 발표자료 원본입니다. 틀 안에서 스크롤해 끝까지 볼 수 있습니다.
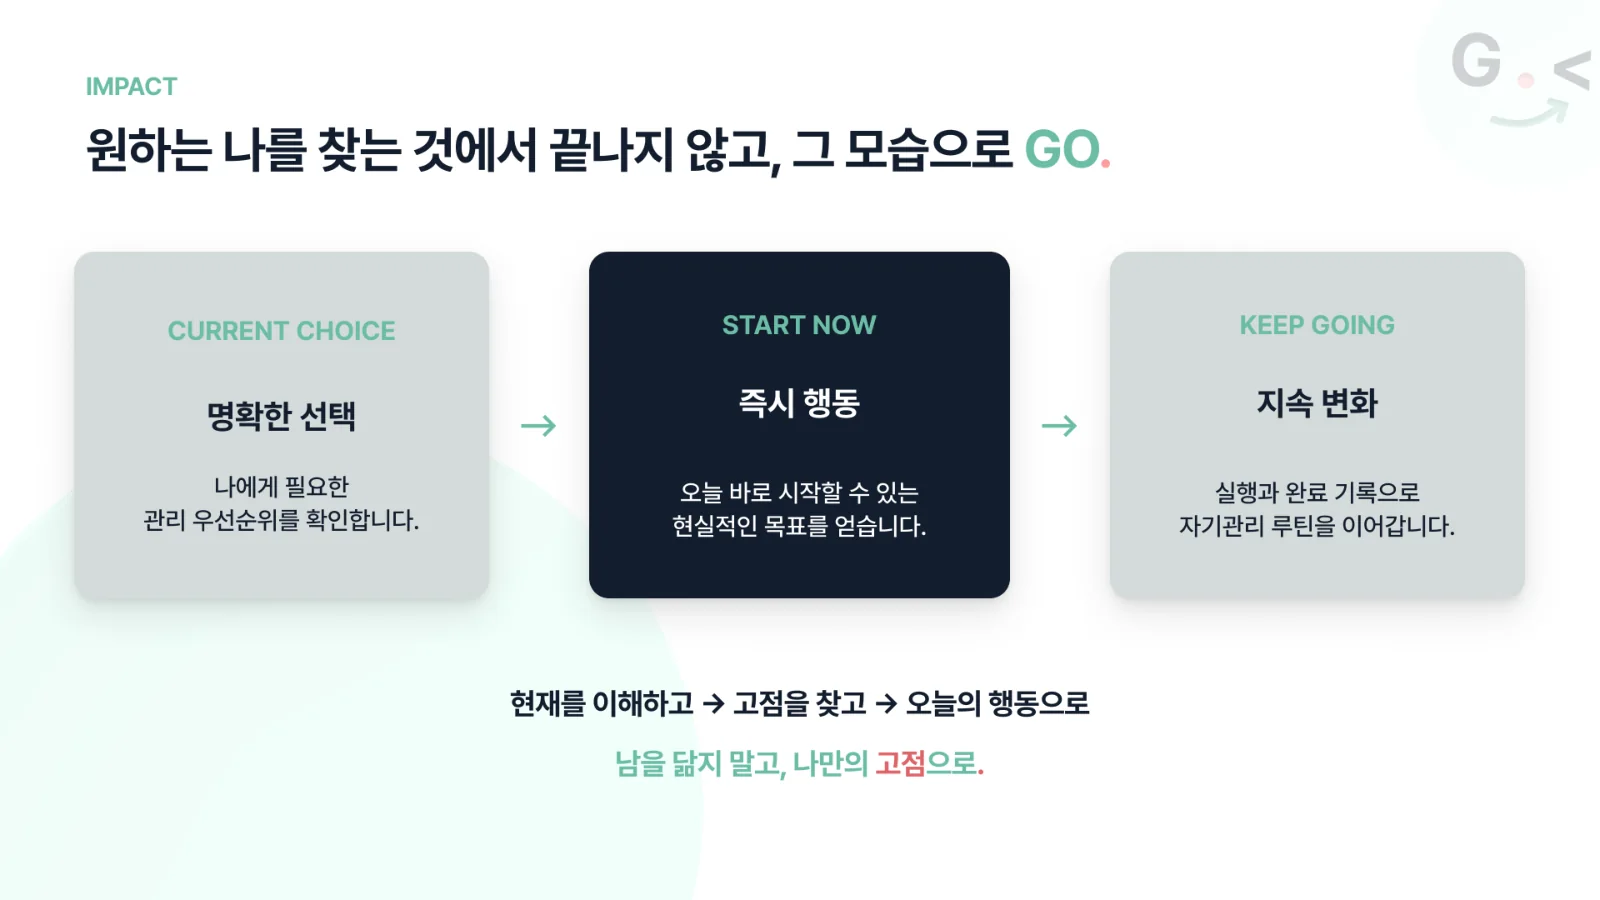
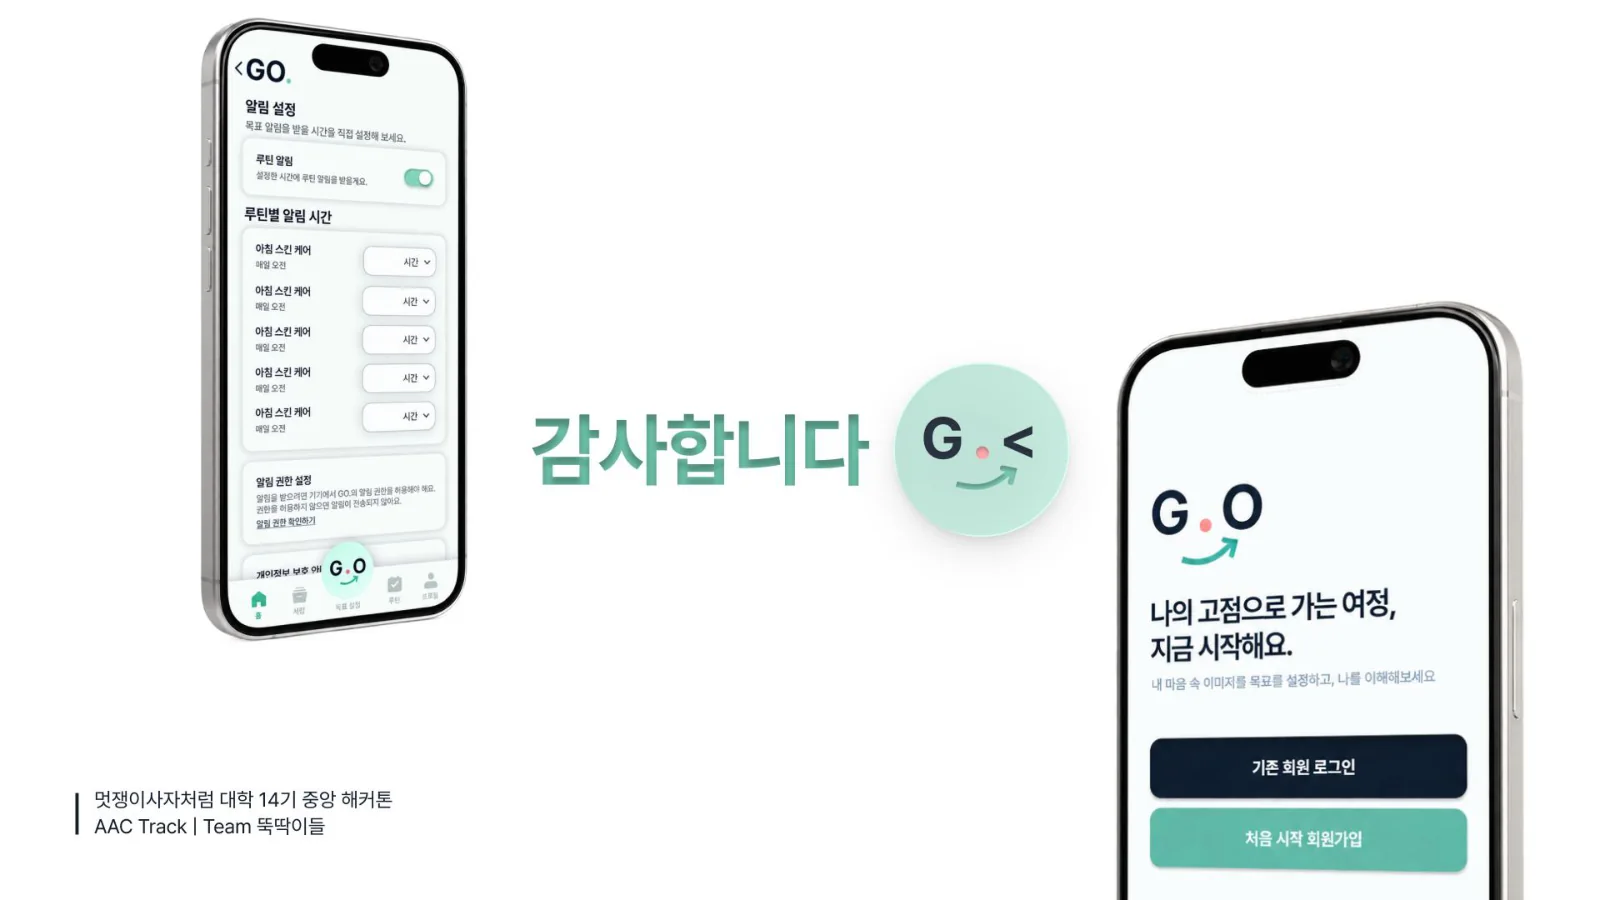
By the numbers
구조를 설명하는 숫자들.
0일
문서 작성부터 운영 배포까지의 실개발 기간
0개 API
백엔드 12개 도메인 · 마이그레이션 17개
0건 테스트
백엔드 통과 기준 · 프론트 119건 별도
Problem
관리와 스타일링 정보는 SNS, 후기, 광고, 병원까지 채널마다 흩어져 있고 신뢰 수준도 제각각입니다. 사용자는 원하는 분위기의 레퍼런스를 저장해 두지만, 그것을 자기 얼굴과 체형과 생활에 어떻게 옮길지는 혼자 조합해야 합니다. 기존 서비스가 주는 점수와 평균값은 분석에는 좋아도 나에게 맞는 기준은 아니고, 수치로 관리하는 방식 자체가 피로를 만듭니다.
Key Decisions
- 01
기준을 평균이 아니라 '고점'으로 잡는다
사용자가 글과 참고 사진으로 적은 되고 싶은 모습을 기준점으로 삼고, 현재 프로필과 비교해 피부·체형·건강 세 영역의 변화 제안을 만듭니다. 외모를 점수나 등급으로 평가하지 않는다는 것을 서비스 원칙이자 서버 검증 규칙으로 못 박았습니다.
- 02
AI는 제안하고, 확정은 사용자가 한다
AI가 뽑은 키워드 후보는 기본 선택 상태가 아닙니다. 사용자가 하나 이상 직접 골라야 결과 생성으로 넘어갑니다. 분석이 도는 동안 이 선택을 받도록 흐름을 짜서, 대기 시간이 곧 사용자가 결정하는 시간이 되게 했습니다.
- 03
이미지가 실패해도 결과는 성립해야 한다
비교 이미지 생성은 가장 느리고 정책 거부도 잦습니다. 그래서 텍스트 결과와 분리된 별도 스레드 풀에서 돌리고, 실패는 예외가 아니라 정상 상태 중 하나로 저장합니다. 이미지가 없어도 화면이 온전하고, 실패한 이미지에 재시도 비용을 더 쓰지 않습니다.
Validation
로그인, 프로필 등록, 고점 입력, 키워드 선택, 결과 확인, 서랍 저장, 목표 설정, 완료 체크까지를 데모 필수 경로로 정하고, 배포한 서버와 실기기 앱으로 이 경로가 끊기지 않는지를 기준으로 삼았습니다. 가드레일 검증기는 금지 패턴별로 단위 테스트를 두었고, 재시작으로 멈춘 분석은 스케줄러가 3분 뒤 실패로 정리하되 분석권은 깎지 않는 것까지 확인했습니다.
How it's built
구조를 그렇게 잡은 이유.
01
얼굴 사진이 API 서버를 지나가지 않는다
업로드와 다운로드 모두 presigned URL로 앱이 스토리지와 직접 통신합니다. DB에는 객체 키만 남고, 서버는 검증할 때만 메모리로 읽고 버립니다. 얼굴 사진은 생체정보에 준하므로 서버 디스크와 백업에 쌓이지 않게 하는 것이 첫 결정이었습니다.
02
AI 호출은 전부 비동기로 뺐다
분석은 60초까지 걸립니다. HTTP 요청은 작업만 등록하고 즉시 202를 돌려주며, 앱은 상태를 폴링합니다. 진행 상태는 메모리 큐나 세션이 아니라 DB에만 둡니다. 서버가 죽었다 살아나도 상태가 어긋나지 않습니다.
03
외부 호출을 트랜잭션 밖으로 꺼냈다
OpenAI 호출을 트랜잭션 안에서 하면 수십 초 동안 DB 커넥션을 붙잡아 풀이 금방 마릅니다. 상태 변경만 짧은 트랜잭션으로 감싸고, 같은 클래스 내부 호출은 프록시를 타지 않으므로 트랜잭션 메서드를 별도 빈으로 분리했습니다. 비동기 시작은 커밋 이후로 걸었습니다.
04
가드레일을 프롬프트에 맡기지 않았다
외모를 점수화하지 않는다, 시술을 권하지 않는다는 원칙을 프롬프트에만 적어두면 언젠가 샙니다. 모든 텍스트 단계를 strict JSON Schema로 강제하고, 서버가 출력에서 점수 패턴과 금지어를 다시 검사합니다. 위반하면 사유를 붙여 한 번 재생성하고, 또 위반하면 실패로 닫습니다.
05
분석권 차감은 UPDATE 한 번으로
조회 후 저장하면 동시 요청에서 중복 차감이 납니다. 잔여가 있을 때만 1을 빼는 단일 UPDATE로 처리하고 반환값으로 성공을 판정합니다. 차감은 결과 저장과 같은 트랜잭션이라, 결과는 남았는데 차감이 안 되거나 그 반대인 상태가 생기지 않습니다.
06
관계형과 JSONB를 한 DB에 뒀다
사용자, 구독, 루틴은 트랜잭션이 필요해 관계형으로, 필드가 계속 바뀌는 AI 결과는 JSONB로 담았습니다. 테스트는 H2 대신 Testcontainers로 실제 PostgreSQL을 띄웁니다. H2는 JSONB를 흉내만 내서 테스트가 통과해도 운영에서 깨지기 때문입니다.
My Contribution
이 프로젝트에서 제가 설계하고 구현한 세 가지입니다.
- 01Async Pipeline
60초짜리 AI 작업을 요청과 분리한 분석 파이프라인
왜
키워드 추출, 결과 생성, 이미지 합성은 각각 수십 초가 걸립니다. 이걸 요청-응답 안에서 처리하면 앱은 멈춘 것처럼 보이고 서버는 커넥션을 붙잡은 채 기다립니다.
어떻게
분석을 상태 기계로 정의하고, 각 단계를 커밋 이후에 시작하는 비동기 작업으로 만들었습니다. 텍스트용과 이미지용 스레드 풀을 나눠 느린 이미지 생성이 텍스트 결과를 막지 않게 했습니다.
- 상태 전이: CREATED → EXTRACTING → KEYWORDS_READY → GENERATING → DONE
- OpenAI 호출은 트랜잭션 밖, 상태 저장만 짧은 트랜잭션
- 429와 5xx만 최대 2회 재시도, 4xx는 재시도하지 않음
- 3분 넘게 진행 상태로 남은 분석은 스케줄러가 실패 처리, 분석권은 미차감
- 02Guardrail
외모를 다루는 서비스가 넘지 말아야 할 선을 코드로
왜
외모 점수화, 시술 권유, 타인 얼굴 복제는 이 서비스가 절대 하면 안 되는 일입니다. 프롬프트에 적어두는 것만으로는 보장이 되지 않습니다.
어떻게
출력 구조는 strict JSON Schema로 강제하고, 서버가 결과 텍스트에서 점수·등급 패턴과 금지어를 다시 검사합니다. 비교 이미지는 참고 사진에서 헤어스타일과 피부 상태만 가져오고 이목구비, 골격, 피부색, 옷, 배경은 사용자 것으로 고정하도록 합성 경계를 정했습니다.
- 위반 시 사유를 덧붙여 1회 재생성, 재위반이면 실패로 종료
- 피부·체형·건강 각 1건인지 서버가 정합성 확인 후 우선순위 순으로 재정렬
- 얼굴 미검출·다인 검출은 서버 OpenCV로 판정 — 같은 사진엔 항상 같은 답
- 인바디 OCR 추출값은 확정 저장하지 않고 사용자 확인을 거침
- 03Process
코드보다 문서를 먼저 쓴 8일
왜
기획, 디자인, 프론트, 백엔드, AI가 8일 안에 같은 방향을 봐야 했고, 개발의 상당 부분을 AI 에이전트와 함께 진행했습니다. 기준 문서 없이는 매 작업이 처음부터 다시 설명하는 일이 됩니다.
어떻게
PRD, ERD, API 명세, 에이전트 작업 규칙을 먼저 커밋했습니다. 첫 14개 커밋에는 기능 코드가 없습니다. 가장 큰 리스크인 AI 연동을 첫 기능 커밋에서 스파이크로 확인한 뒤 인증과 스토리지 같은 정형 작업을 붙였습니다.
- 커밋 131개 중 126개를 AI 에이전트와 공동 저작
- 인수인계 문서 10개 — 세션이 바뀌어도 맥락이 이어지게
- 같은 실수를 반복하지 않으려고 쌓은 오답 노트 21건
- 가격 같은 정책값은 서버 한 곳에만 두어 앱 재빌드 없이 변경
Analysis Lifecycle
분석 요청 한 번이 서버 안에서 지나가는 길입니다.
요청 접수
프로필이 있는지, 분석권이 남았는지 확인하고 분석을 생성해 커밋합니다. 응답은 즉시 돌려주고, 파이프라인은 커밋이 끝난 뒤에 시작합니다. 커밋 전에 시작하면 비동기 스레드가 아직 없는 행을 조회하게 됩니다.
POST /analyses · 202 Accepted · AFTER_COMMIT
키워드 추출
고점 텍스트와 참고 사진에서 키워드 후보 5~8개를 뽑습니다. 후보가 하나도 나오지 않으면 더 구체적으로 적어 달라고 안내하고 예시 문장을 보여줍니다.
EXTRACTING → KEYWORDS_READY
사용자 선택
분석 중 화면 위에 키워드 카드를 띄우고, 사용자가 1개에서 4개까지 직접 고릅니다. 고르기 전에는 저장 버튼이 비활성입니다.
POST /analyses/{id}/keywords/selection
결과 생성
현재 프로필, 선택 키워드, 우선순위 가중치로 요약과 유지할 점, 강조할 점, 영역별 변화 3건, 오늘의 관리 3건을 만듭니다. 1순위 영역은 가장 구체적으로, 3순위는 간결하게 생성합니다.
GENERATING · Structured Outputs
후검증과 저장
점수 패턴과 금지어, 영역별 1건 규칙을 서버가 확인한 뒤 결과 저장, 분석권 차감, 완료 처리를 한 트랜잭션으로 묶습니다.
OutputValidator · DONE
비교 이미지
참고 사진이 있을 때만 별도 풀에서 생성합니다. 결과는 스토리지에 올리고 DB에는 키만 남깁니다. 정책 거부를 포함한 실패는 상태로 기록하고 텍스트 결과는 그대로 보여줍니다.
image_status = SKIPPED | PENDING | DONE | FAILED
Credit Consumption
동시 요청에도 분석권이 두 번 깎이지 않게 하는 쿼리입니다.
SubscriptionRepository.java
@Modifying
@Query("""
    UPDATE Subscription s SET s.analysisCredits = s.analysisCredits - 1
    WHERE s.id = :id AND s.analysisCredits > 0
""")
int consumeCredit(@Param("id") UUID id);
반환값이 0이면 잔여 분석권이 없다는 뜻입니다. 결과 저장과 같은 트랜잭션에서 실행하고, 타임아웃이나 정책 차단처럼 사용자 잘못이 아닌 실패에서는 호출하지 않습니다.
Key Specs
설명에 근거가 되는 설정값입니다.
비동기 · AI 호출
- 타임아웃
- connect 5s · read 60s
- 재시도
- 429 · 5xx만 최대 2회, 지수 백오프
- 분석 풀
- core 8 · max 16 · queue 100
- 이미지 풀
- core 4, 텍스트 파이프라인과 분리
- 좀비 정리
- 1분 주기, 3분 초과 시 FAILED
- 모델 ID
- 환경변수로 고정, 실제 사용값을 ai_jobs에 기록
스토리지 · 보안
- 업로드 URL
- PUT 300초 만료 · 10MB 상한을 서명에 포함
- 조회 URL
- GET 600초 만료
- 소유권
- 저장 시점에 objectKey가 요청자 경로인지 재확인
- 인증
- JWT Access 30분 · Refresh 14일 · Google 로그인
- 로그
- 사진 · 프롬프트 · 토큰 원문 미기록
- 삭제
- 사진·계정 삭제 시 객체 즉시 삭제
구독 모델
- 요금
- 월 4,900원 · 연 49,000원
- 무료 체험
- 한 달 · 분석권 1회
- 차감 시점
- 결과 생성 성공 시, 실패하면 미차감
- 만료 후
- 저장한 결과와 목표는 열람 가능, 신규 생성만 차단
- 원가 추정
- 분석 1회 약 200~300원, 대부분 이미지 생성 (추정치)
- 가격 근거
- 다른 구독을 끊지 않고 추가할 수 있는 5천원 미만 구간
Current State
어디까지 실제로 돌아가는지 구분해 적었습니다.
서버와 실기기에서 동작
- 이메일 · Google 로그인과 토큰 갱신
- 프로필 등록 — 사진, 우선순위, 신체 정보, 서버 얼굴 검출
- 고점 분석 — 키워드 추출, 사용자 선택, 결과 생성, 가드레일 후검증
- 비교 이미지 생성과 서랍 저장 · 열람
- 목표 생성 두 경로, 완료 체크, 목표 알림
- 상품 추천 — AI는 서버가 가진 상품 id 안에서만 선택
- 구독 상태 전환, 만료 처리, 분석권 차감과 기능 게이팅
남은 것 · 정하지 못한 것
- PG 결제 연동 — 구독 상태 로직은 있으나 실제 결제는 붙지 않음
- 개인정보 동의 화면과 만 14세 확인 — 법적 요구사항, 상용 배포 전 필수
- 키워드 정책 — 시술 용어나 제품 호수가 키워드로 나올 때의 허용 범위 미결
- 홈 화면의 수치 표시가 '점수화하지 않는다'는 원칙과 충돌 — 정책 결정 전
- 단일 인스턴스 전제 — 확장하려면 메시지 큐와 스케줄러 락이 필요
- 실제 인물 사진 전수 검증과 안드로이드 Google 로그인 확인은 끝내지 못함
한계를 숨기지 않고 문서에 미결 사항으로 남겨 두었습니다. 상용화 전에 풀어야 할 순서는 동의 화면, 수치 표시 정책, 결제 순입니다.